 Cams Support Hub
Arquitectura de adaptadores de protocolo: del SDK heredado a la API en la nube
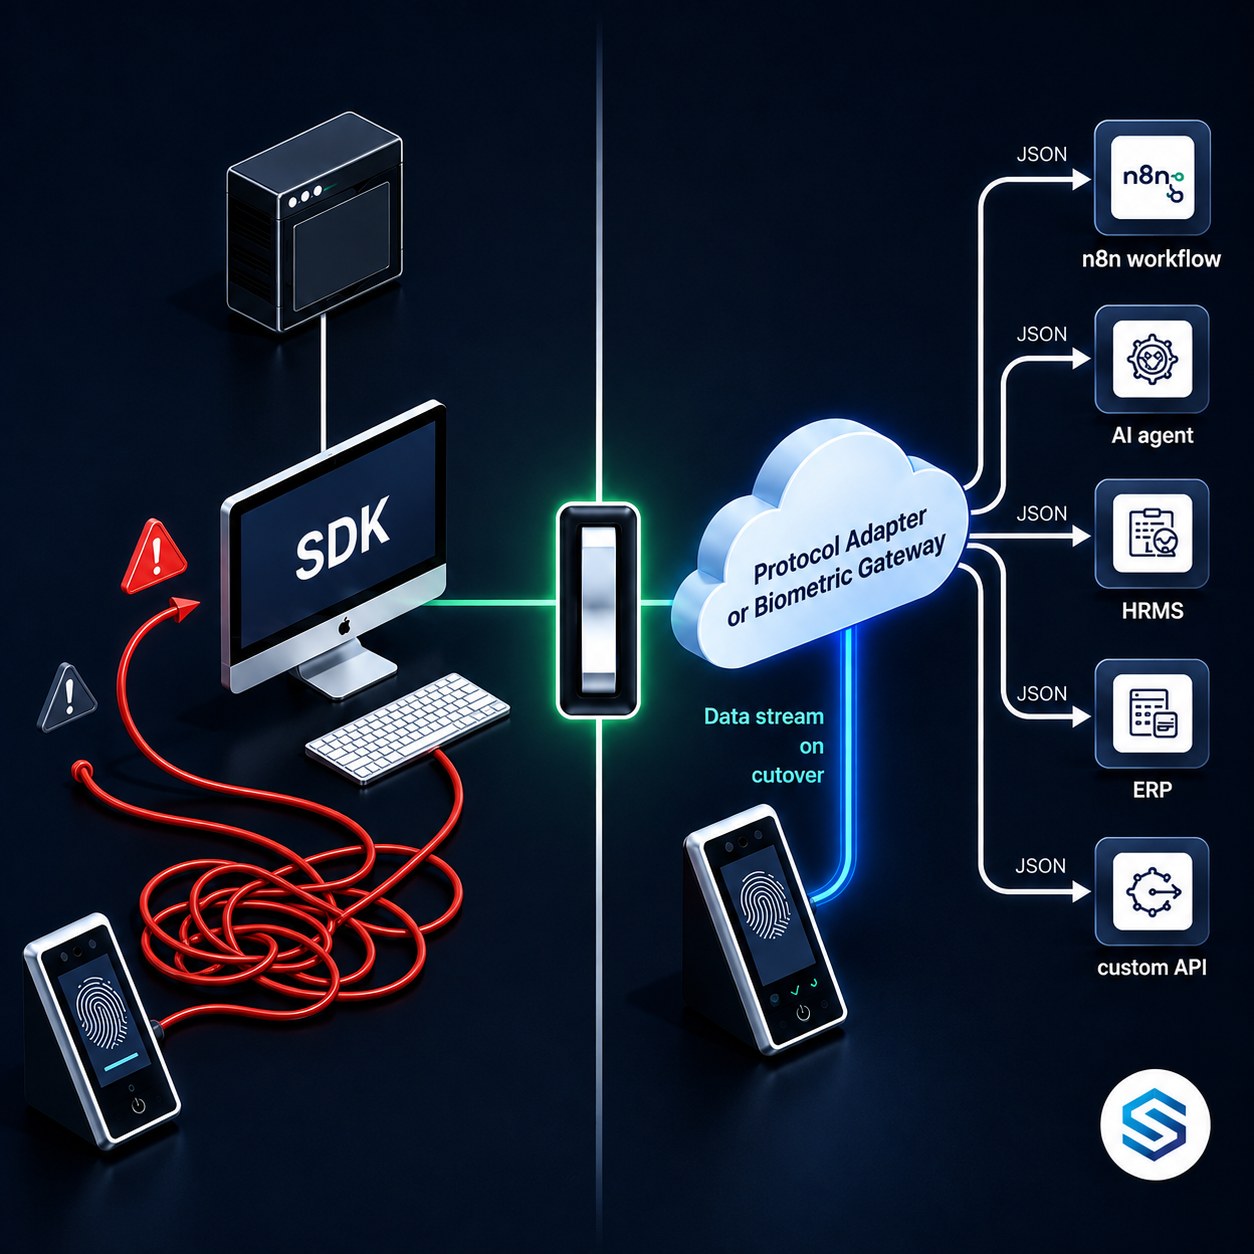
La mayoría de los sistemas empresariales no se diseñaron para comunicarse entre sí. Se diseñaron para realizar una tarea específica, usando el modelo de comunicación que tenía sentido en el momento de su diseño. La arquitectura de adaptadores de protocolo es la disciplina de ingeniería que conecta estos mundos sin reescribir ninguno de ellos. Este artículo explica qué son los adaptadores de protocolo, cómo funcionan a nivel técnico y por qué son la solución más pragmática a uno de los problemas más persistentes de la integración empresarial: el dispositivo biométrico.
Qué es un protocolo y por qué genera dependencia
Antes de entender los adaptadores de protocolo, necesita una definición clara de lo que es realmente un protocolo. En la comunicación de software y hardware, un protocolo es un conjunto de reglas que gobiernan cómo se formatean, transmiten e interpretan los datos entre dos partes. Define la estructura de los paquetes, el modelo de conexión, la secuencia de enlace, el formato de codificación y el comportamiento del manejo de errores.
Los protocolos generan dependencia porque exigen que ambas partes hablen el mismo idioma. Si escribe software que se comunica usando el Protocolo A, solo podrá comunicarse con sistemas que también implementen el Protocolo A. Cualquier sistema que use el Protocolo B, por muy similar que sea funcionalmente, será inaccesible sin una capa de traducción.
Esto no es un defecto del diseño de protocolos. Es una consecuencia inevitable de la comunicación estructurada. El problema surge cuando el protocolo que usa un dispositivo o sistema queda obsoleto frente a los estándares de comunicación que ha adoptado el resto del ecosistema. El dispositivo sigue funcionando. Sus datos siguen siendo valiosos. Pero su protocolo se ha convertido en un muro.
Un terminal biométrico de huellas dactilares fabricado en 2010 se comunica mediante un protocolo binario TCP definido por su fabricante. El terminal registra los datos de asistencia con precisión todos los días. Pero el HRMS que su empresa adoptó en 2023 se comunica mediante REST y JSON sobre HTTPS. Estos dos sistemas no comparten ningún protocolo común. No pueden comunicarse directamente, independientemente de lo capaz que sea cada sistema por separado. Los datos del terminal son inaccesibles para el HRMS a menos que algo traduzca entre los dos protocolos.
El SDK como decodificador de protocolos: qué hace realmente
Cuando un fabricante de dispositivos biométricos no puede exponer su dispositivo mediante un protocolo estándar, distribuye un SDK. Comprender qué hace realmente un SDK a nivel técnico ayuda a explicar tanto por qué existe como por qué genera problemas arquitectónicos tan significativos.
Un SDK, o Software Development Kit (kit de desarrollo de software), es un conjunto de bibliotecas de código compilado, archivos de cabecera y documentación que un desarrollador instala en una máquina para habilitar la comunicación con un dispositivo o servicio específico. En el contexto de los dispositivos biométricos, el SDK realiza dos funciones críticas.
En primer lugar, gestiona la capa de conexión. El SDK establece y mantiene la conexión persistente por socket TCP que espera el dispositivo. Gestiona la secuencia de enlace, mantiene la conexión activa y se encarga de la reconexión cuando el dispositivo se desconecta. Este código de gestión de conexiones es complejo y totalmente específico de la implementación del protocolo del fabricante.
En segundo lugar, gestiona la capa de decodificación. Cada paquete que envía el dispositivo llega como bytes binarios sin procesar. El SDK contiene tablas de búsqueda, máscaras de bits y funciones de análisis que decodifican estos bytes en estructuras de datos significativas con las que un desarrollador puede trabajar. Sin esta capa de decodificación, el flujo binario que llega desde el dispositivo carece de sentido.
Un flujo continuo de bytes binarios por un socket TCP persistente. El significado de cada byte depende de su posición dentro del paquete, del identificador del tipo de paquete y de la versión del firmware del dispositivo. En esta capa no existe ninguna estructura legible por personas.
Llamadas a funciones con nombre y objetos de datos. enrollUser(), getAttendanceLogs(), revokeAccess(). El SDK traduce el mundo binario en una interfaz programática que un desarrollador puede invocar sin conocer nada sobre el formato de transmisión subyacente.
En un sentido limitado, el SDK es un adaptador de protocolo. Adapta el protocolo binario del dispositivo a una interfaz de programación invocable. El problema arquitectónico es que esta adaptación solo funciona en una dirección, solo en las máquinas donde está instalado el SDK, solo para la marca específica de dispositivo para la que fue escrito y solo dentro del modelo de ejecución del lenguaje para el que se compiló el SDK.
Por qué la arquitectura basada en SDK no puede escalar
El modelo de SDK fue una solución razonable para el mundo para el que se diseñó: una única aplicación de escritorio, ejecutándose en una máquina local, comunicándose con una sola marca de dispositivo a través de una red de área local. En ese contexto, el SDK funciona bien. Las limitaciones solo se hacen visibles cuando cambian los requisitos arquitectónicos.
El problema de la dependencia de instalación
Un SDK debe instalarse en la máquina que ejecuta el código de integración. Esto significa que su integración no puede ejecutarse en un entorno de nube en contenedores, en una función sin servidor ni en una plataforma de automatización alojada. Debe ejecutarse en una máquina específica con los archivos del SDK presentes. Si esa máquina se da de baja, se reconstruye o se migra a un sistema operativo diferente, la integración se rompe.
En 2026, la mayor parte de la infraestructura de software empresarial ha evolucionado hacia despliegues nativos en la nube. La orquestación de contenedores, las funciones sin servidor y los servicios de nube gestionados son el estándar. Una dependencia de SDK es arquitectónicamente incompatible con este modelo, porque los contenedores son sin estado y efímeros. No mantienen bibliotecas de software instaladas entre despliegues.
El problema de la multiplicidad de marcas
Cada fabricante de dispositivos biométricos distribuye su propio SDK. Estos SDK no son interoperables. El SDK de ZKTeco no puede comunicarse con un dispositivo Hikvision. El SDK de Suprema no puede comunicarse con un dispositivo Anviz. Si su organización ha desplegado hardware de varios fabricantes en distintas sedes, necesita una integración de SDK independiente para cada marca.
Esto multiplica cada carga de mantenimiento. Una actualización de firmware de un fabricante puede cambiar la estructura binaria de los paquetes, rompiendo la integración del SDK para esa marca mientras las demás no se ven afectadas. Cada integración debe mantenerse, supervisarse y actualizarse de forma independiente.
El problema de la frontera entre lenguaje y entorno de ejecución
La mayoría de los SDK de dispositivos biométricos se distribuyen como bibliotecas compiladas en C o C++ con binarios específicos de Windows. Si su capa de integración está escrita en Python, Node.js o Go, se enfrenta a un problema de traducción adicional: llamar a funciones de bibliotecas en C desde un entorno de ejecución gestionado requiere código de interfaz de funciones externas específico de cada plataforma, que es frágil y difícil de mantener entre versiones del sistema operativo.
Un equipo de ingeniería que ha creado integraciones de SDK para tres marcas de dispositivos biométricos no mantiene una sola integración. Mantiene tres bases de código completamente separadas, cada una con su propia lógica de conexión, código de análisis binario, manejo de errores y superficie de compatibilidad con el firmware. Cuando una actualización de firmware rompe una integración, diagnosticar el problema requiere un conocimiento profundo del protocolo binario de ese fabricante concreto, un conocimiento que rara vez está documentado y que a menudo solo reside en la mente del ingeniero que escribió originalmente la integración.
El patrón de adaptador de protocolo: una definición formal
El patrón de adaptador de protocolo es un patrón de arquitectura de software bien establecido que resuelve el problema de los protocolos de comunicación incompatibles mediante la introducción de una capa de traducción dedicada entre los dos sistemas. El adaptador habla el idioma nativo del sistema de origen por un lado y el idioma esperado por el sistema de destino por el otro. Ninguno de los dos sistemas necesita cambiar.
En la ingeniería de software, este patrón se denomina a veces patrón Adapter o patrón Translator. En la ingeniería de redes, es el principio que hay detrás de las pasarelas de protocolo. En la integración empresarial, es la base de los brokers de mensajes y las plataformas de integración. Los detalles concretos de implementación varían, pero el concepto arquitectónico central es coherente: aislar la responsabilidad de la traducción para que ni el sistema de origen ni el de destino necesiten conocer o preocuparse por el modelo de comunicación del otro.
Un adaptador eléctrico universal le permite conectar un dispositivo con clavija europea de dos patillas a una toma británica de tres patillas. El dispositivo no cambia. La toma no cambia. El adaptador gestiona la traducción entre dos estándares físicos incompatibles. Un adaptador de protocolo hace lo mismo con los estándares de comunicación de software. El dispositivo biométrico sigue hablando su protocolo binario. La API en la nube sigue hablando JSON sobre HTTPS. El adaptador traduce entre ambos.
Las cuatro capas de un adaptador de protocolo biométrico
Un adaptador de protocolo biométrico bien diseñado no es una sola función. Es una arquitectura en capas en la que cada capa tiene una responsabilidad específica y acotada. Comprender estas capas ayuda a explicar por qué construir un adaptador robusto es más complejo de lo que parece a primera vista, y por qué una solución diseñada específicamente es considerablemente más fiable que una integración a medida.
Dentro del núcleo del adaptador: qué implica realmente la traducción
El núcleo del adaptador es donde reside la verdadera complejidad. Cada uno de sus cinco componentes aborda un desafío técnico específico que hace impracticable la integración directa.
Gestor de conexiones
Los dispositivos biométricos esperan una conexión TCP persistente. El gestor de conexiones mantiene un socket de larga duración por dispositivo, gestiona el enlace específico del fabricante que autentica el software ante el dispositivo, supervisa el estado de la conexión mediante sondas keepalive, detecta desconexiones y ejecuta la lógica de reconexión con un tiempo de espera exponencial adecuado. En un sistema que gestiona 50 dispositivos en varias sedes, el gestor de conexiones ejecuta 50 sesiones de socket concurrentes de forma simultánea, cada una con su propia máquina de estados.
Decodificador binario
Cada paquete que llega desde un dispositivo es una secuencia de bytes con una estructura específica definida por el fabricante. El decodificador binario analiza estos paquetes leyendo campos de ancho fijo en desplazamientos de byte conocidos, aplicando máscaras de bits para extraer valores de indicadores, convirtiendo las marcas de tiempo codificadas en binario a formatos de fecha y hora estándar y decodificando conjuntos de caracteres que pueden no ser UTF-8 estándar. El decodificador debe gestionar múltiples tipos de paquete, identificados por un byte de tipo en un desplazamiento conocido, y dirigir cada tipo de paquete a la rutina de análisis adecuada.
Normalizador de eventos
Un evento de escaneo de huella dactilar en un dispositivo ZKTeco llega con nombres de campo, formatos de marca de tiempo y códigos de estado distintos a los del evento equivalente en un dispositivo Hikvision. El normalizador de eventos asigna cada representación de evento específica del fabricante a un único esquema de evento interno coherente. Este paso de normalización es lo que permite que la Capa 3 y la Capa 4 sean totalmente independientes de la marca. El consumidor recibe la misma estructura JSON independientemente del dispositivo que haya generado el evento.
{
  "RealTime": {
    "OperationID": "9nu1wak5616p",
    "LabelName": "Burj Khalifa",
    "SerialNumber": "ZHM11xxxxxxxx",
    "PunchLog": {
      "Type": "CheckIn",
      "Temperature": "36.8",
      "FaceMask": false,
      "InputType": "Fingerprint",
      "UserId": "2",
      "LogTime": "2020-09-17 07:48:22 GMT +0530"
    },
    "AuthToken": "COJJ7eiiPBGUfmIQPvh2PJWWDLX7OuKs",
    "Time": "2020-09-17 04:19:03 GMT +0000"
  }
}
Codificador de comandos
La carga de punchlog anterior es lo que producen el Decodificador binario y el Normalizador de eventos cuando llega un evento biométrico en tiempo real a Biometric Gateway desde un dispositivo físico. Este JSON estructurado se publica después en el endpoint de callback configurado, ya sea un nodo Webhook de n8n, un agente de IA, un endpoint HRMS o cualquier otro consumidor.
El Codificador de comandos funciona en la dirección opuesta. Cuando un consumidor envía una instrucción JSON a la superficie de API, por ejemplo una solicitud para registrar un nuevo usuario o revocar permisos de acceso, el Codificador de comandos traduce ese JSON estructurado en el paquete de comando binario que espera el dispositivo de destino. Coloca los valores de los campos en los desplazamientos de byte correctos para el protocolo de ese fabricante, antepone el identificador del tipo de paquete, calcula y añade las sumas de comprobación requeridas y escribe la trama binaria resultante en el socket persistente del dispositivo. La misma instrucción lógica, expresada una sola vez como JSON limpio por el consumidor, se convierte en una estructura binaria completamente distinta en la transmisión según la marca del dispositivo que la reciba. El Codificador de comandos gestiona internamente cada variante para que el consumidor nunca tenga que hacerlo.
Gestor de resiliencia
Los dispositivos físicos en entornos operativos se desconectan. Los cortes de energía, las interrupciones de red y los reinicios de dispositivos son eventos habituales. El gestor de resiliencia almacena en búfer los eventos que llegan durante una desconexión para que no se pierdan, pone en cola los comandos salientes que no pueden entregarse hasta que se restablezca la conexión, implementa un tiempo de espera exponencial para los intentos de reconexión y evita saturar un dispositivo que se está reiniciando, y devuelve respuestas de error estructuradas a los consumidores cuando una operación no puede completarse por indisponibilidad del dispositivo.
Las propiedades arquitectónicas que definen un buen adaptador de protocolo
No todos los adaptadores de protocolo son iguales. Un adaptador bien diseñado tiene propiedades arquitectónicas específicas que lo distinguen de una integración a medida frágil.
Por qué el despliegue en la nube cambia los requisitos de la arquitectura del adaptador
El paso de una infraestructura empresarial local a una nativa en la nube cambia fundamentalmente lo que debe ser un adaptador de protocolo. Un adaptador diseñado para un despliegue local puede depender de instalaciones de SDK locales, configuraciones de red fijas y procesos de servidor persistentes. Un adaptador diseñado para la nube no puede depender de ninguno de ellos.
Diseño sin estado frente a diseño con estado
Los entornos de despliegue nativos en la nube favorecen los procesos sin estado. Un proceso sin estado puede iniciarse, detenerse y reiniciarse sin perder datos importantes, porque todo el estado persistente se almacena externamente. Las conexiones con dispositivos biométricos son inherentemente con estado: requieren un socket persistente que mantenga el contexto de la conexión entre interacciones. Un adaptador de protocolo nativo en la nube debe externalizar este estado, manteniendo los metadatos de la conexión en un almacén persistente para que el contexto sobreviva a los reinicios del proceso.
La separación entre la gestión de conexiones y el servicio de API
Un adaptador de protocolo para la nube bien arquitectado separa la capa de gestión de conexiones de la capa de servicio de API. La capa de gestión de conexiones se ejecuta como un servicio dedicado que mantiene conexiones persistentes con los dispositivos y publica los eventos normalizados en una cola de mensajes interna. La capa de servicio de API lee de esa cola y atiende las solicitudes REST de forma independiente. Esta separación permite que cada capa escale por separado y hace que el reinicio de un proceso del servicio de API no interrumpa las conexiones activas con los dispositivos.
Si su servidor de API y su gestor de conexiones de dispositivos son el mismo proceso, reiniciar el servidor de API para desplegar una actualización rompe todas las conexiones activas con los dispositivos. Si son procesos separados, puede desplegar actualizaciones en el servidor de API sin tocar el gestor de conexiones, y las conexiones activas con los dispositivos siguen sin interrupción. En un entorno operativo donde los dispositivos procesan eventos de asistencia de forma continua, la continuidad de la conexión no es una comodidad. Es un requisito de integridad de los datos.
La ruta de migración: pasar del SDK al adaptador de protocolo
Las organizaciones que actualmente dependen de integraciones basadas en SDK no necesitan reconstruirlo todo de una vez. La arquitectura de adaptadores de protocolo está diseñada para introducirse de forma incremental, de modo que el adaptador vaya asumiendo gradualmente las responsabilidades de la integración SDK existente.
Consideraciones de cumplimiento en el diseño de adaptadores de protocolo
Cuando los datos biométricos fluyen a través de un adaptador de protocolo, el adaptador se convierte en un encargado del tratamiento en sentido jurídico según la mayoría de los marcos de protección de datos. Esto crea obligaciones de diseño específicas que deben abordarse en la arquitectura del adaptador.
- RGPD, UE: El adaptador debe aplicar la minimización de datos en la capa de normalización. Los datos de eventos que se transfieren a los consumidores deben contener únicamente los campos necesarios para la finalidad específica. El adaptador no debe conservar los datos de plantillas biométricas más tiempo del necesario para la operación en curso.
- CCPA y CPRA, California: El adaptador no debe poner los datos biométricos a disposición de los consumidores de forma que permitan la elaboración de perfiles o la reidentificación más allá de la finalidad consentida. Los controles de acceso a la API deben aplicar la limitación de finalidad a nivel de consumidor.
- LGPD, Brasil: Los registros de tratamiento deben documentar el adaptador como componente de tratamiento, con su función específica, los datos a los que accede y las reglas de conservación aplicadas en cada capa.
- PDPA, Singapur, Malasia, Tailandia: Los controles de acceso en la superficie de API deben aplicar restricciones basadas en el consentimiento. Los consumidores solo deben recibir datos para las finalidades a las que el interesado haya consentido.
- Controles alineados con ISO 27001: El adaptador debe aplicar cifrado en tránsito tanto en la capa de conexión con los dispositivos (cuando el protocolo del dispositivo lo permita) como en la capa de superficie de API. El acceso a los endpoints de la API debe estar autenticado. Todas las operaciones deben generar entradas de registro de auditoría inmutables.
Preguntas frecuentes
Conclusión: Cams Biometrics Gateway es esta arquitectura, construida y en funcionamiento
La arquitectura de adaptadores de protocolo es la respuesta de ingeniería correcta al problema de la integración biométrica. No es un atajo. Es un patrón bien establecido aplicado a un ámbito específico en el que resulta urgentemente necesario.
Cams Biometrics Gateway es una implementación en producción de esta arquitectura. Mantiene conexiones persistentes con dispositivos de 15 o más fabricantes, ejecuta un decodificador binario y un normalizador de eventos para cada protocolo soportado y expone el conjunto completo de operaciones a través de una API REST unificada y de un servidor MCP. El resultado son 38 operaciones biométricas accesibles mediante JSON estándar sobre HTTPS, con callbacks de webhook en tiempo real para cada evento de los dispositivos y sin necesidad de instalar ningún SDK en su infraestructura.
Si su organización dispone de dispositivos biométricos y de sistemas que necesitan consumir datos biométricos, la capa de adaptador de protocolo es la pieza arquitectónica que le falta. Explore la API de Cams Biometrics Gateway en CamsBiometrics.com o hable con nuestro equipo para conectar su hardware existente a la API moderna en la nube que merece.