 Cams Support Hub
प्रोटोकॉल एडैप्टर आर्किटेक्चर: लीगेसी SDK से क्लाउड API तक
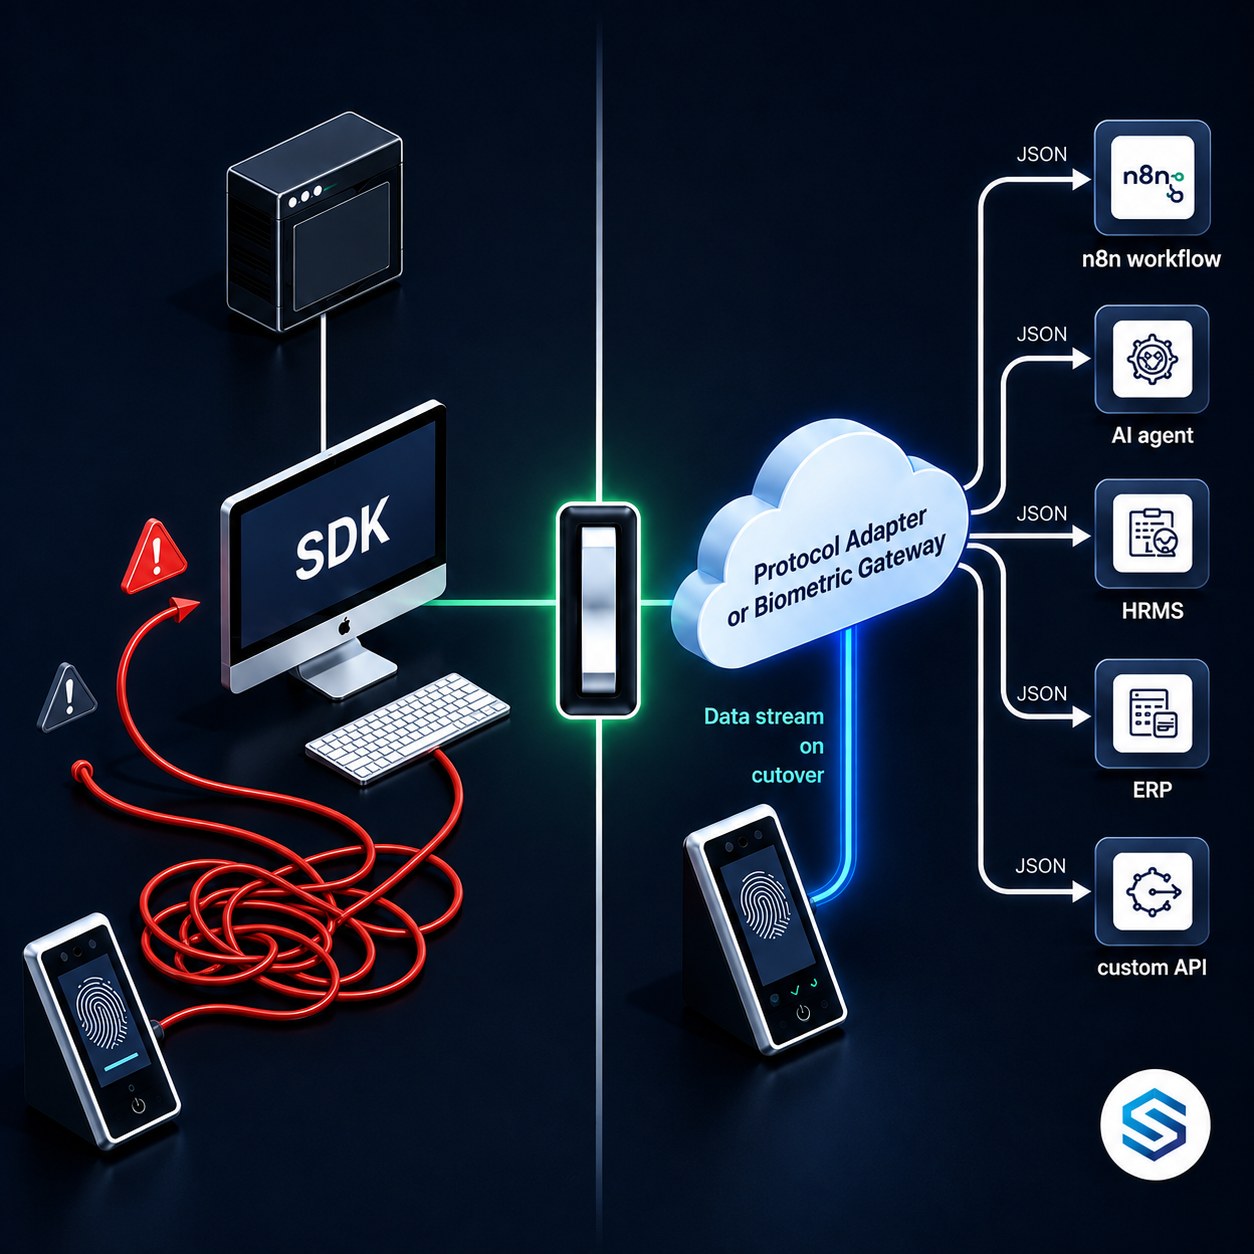
अधिकांश एंटरप्राइज़ सिस्टम एक-दूसरे से बात करने के लिए नहीं बनाए गए थे। उन्हें एक विशेष कार्य करने के लिए बनाया गया था, और उस समय के संचार मॉडल का उपयोग किया गया था जो डिज़ाइन के समय उचित लगता था। प्रोटोकॉल एडैप्टर आर्किटेक्चर वह इंजीनियरिंग अनुशासन है जो इन दुनियाओं को किसी एक को भी दोबारा लिखे बिना जोड़ता है। यह लेख बताता है कि प्रोटोकॉल एडैप्टर क्या होते हैं, वे तकनीकी स्तर पर कैसे काम करते हैं, और एंटरप्राइज़ इंटीग्रेशन की सबसे लगातार बनी रहने वाली समस्याओं में से एक, यानी बायोमेट्रिक डिवाइस, के लिए वे सबसे व्यावहारिक समाधान क्यों हैं।
प्रोटोकॉल क्या है और यह लॉक-इन क्यों बनाता है
प्रोटोकॉल एडैप्टर को समझने से पहले, आपको यह स्पष्ट रूप से जानना होगा कि प्रोटोकॉल वास्तव में क्या है। सॉफ़्टवेयर और हार्डवेयर संचार में, प्रोटोकॉल नियमों का एक सेट है जो यह तय करता है कि डेटा दो पक्षों के बीच कैसे फ़ॉर्मेट, ट्रांसमिट और इंटरप्रेट किया जाता है। यह पैकेट संरचना, कनेक्शन मॉडल, हैंडशेक क्रम, एन्कोडिंग फ़ॉर्मेट और त्रुटि प्रबंधन के व्यवहार को परिभाषित करता है।
प्रोटोकॉल लॉक-इन इसलिए बनाते हैं क्योंकि उनमें दोनों पक्षों को एक ही भाषा बोलनी होती है। यदि आप ऐसा सॉफ़्टवेयर लिखते हैं जो Protocol A का उपयोग करके संचार करता है, तो वह केवल उन्हीं सिस्टम्स से संवाद कर सकता है जो Protocol A भी लागू करते हैं। Protocol B का उपयोग करने वाला कोई भी सिस्टम, चाहे वह कार्यात्मक रूप से कितना भी समान क्यों न हो, एक ट्रांसलेशन लेयर के बिना पहुँच से बाहर रहता है।
यह प्रोटोकॉल डिज़ाइन की कोई खामी नहीं है। यह संरचित संचार का एक अपरिहार्य परिणाम है। समस्या तब उत्पन्न होती है जब कोई डिवाइस या सिस्टम जो प्रोटोकॉल उपयोग करता है, वह इकोसिस्टम के बाकी हिस्सों द्वारा अपनाए गए संचार मानकों के सापेक्ष पुराना हो जाता है। डिवाइस अब भी काम करता है। उसका डेटा अब भी मूल्यवान है। लेकिन उसका प्रोटोकॉल एक दीवार बन चुका है।
वर्ष 2010 में निर्मित एक बायोमेट्रिक फ़िंगरप्रिंट टर्मिनल अपने निर्माता द्वारा परिभाषित एक बाइनरी TCP प्रोटोकॉल का उपयोग करके संचार करता है। यह टर्मिनल हर दिन उपस्थिति (attendance) का डेटा सटीक रूप से कैप्चर करता है। लेकिन आपकी कंपनी ने वर्ष 2023 में जो HRMS अपनाया, वह REST और JSON के माध्यम से HTTPS पर संचार करता है। इन दोनों सिस्टम्स का कोई साझा प्रोटोकॉल नहीं है। चाहे दोनों सिस्टम अलग-अलग कितने भी सक्षम क्यों न हों, वे सीधे संवाद नहीं कर सकते। टर्मिनल पर मौजूद डेटा HRMS के लिए तब तक अप्राप्य है जब तक कोई चीज़ इन दोनों प्रोटोकॉल के बीच अनुवाद न करे।
प्रोटोकॉल डिकोडर के रूप में SDK: यह वास्तव में क्या करता है
जब कोई बायोमेट्रिक डिवाइस निर्माता अपने डिवाइस को किसी मानक प्रोटोकॉल के माध्यम से उपलब्ध नहीं करा पाता, तो वह एक SDK वितरित करता है। तकनीकी स्तर पर SDK वास्तव में क्या करता है, यह समझने से यह स्पष्ट होता है कि यह क्यों मौजूद है और यह इतनी महत्वपूर्ण आर्किटेक्चरल समस्याएँ क्यों पैदा करता है।
SDK, या Software Development Kit, कंपाइल्ड कोड लाइब्रेरी, हेडर फ़ाइलों और दस्तावेज़ीकरण का एक संग्रह है, जिसे डेवलपर किसी मशीन पर इंस्टॉल करता है ताकि किसी विशिष्ट डिवाइस या सेवा के साथ संचार संभव हो सके। बायोमेट्रिक डिवाइसों के संदर्भ में, SDK दो महत्वपूर्ण कार्य करता है।
पहला, यह कनेक्शन लेयर को संभालता है। SDK वह स्थायी TCP सॉकेट कनेक्शन स्थापित और बनाए रखता है जिसकी डिवाइस अपेक्षा करता है। यह हैंडशेक क्रम को प्रबंधित करता है, कनेक्शन को सक्रिय रखता है, और डिवाइस के ऑफ़लाइन होने पर पुनः कनेक्शन को संभालता है। यह कनेक्शन प्रबंधन कोड जटिल है और पूरी तरह से निर्माता के प्रोटोकॉल कार्यान्वयन के लिए विशिष्ट है।
दूसरा, यह डिकोडिंग लेयर को संभालता है। डिवाइस द्वारा भेजा गया हर पैकेट कच्चे बाइनरी बाइट्स के रूप में आता है। SDK में लुकअप टेबल, बिट मास्क और पार्सिंग फ़ंक्शन होते हैं जो इन बाइट्स को सार्थक डेटा संरचनाओं में बदलते हैं जिनके साथ डेवलपर काम कर सकता है। इस डिकोडिंग लेयर के बिना, डिवाइस से आने वाली बाइनरी स्ट्रीम का कोई अर्थ नहीं होता।
एक स्थायी TCP सॉकेट पर बाइनरी बाइट्स की लगातार स्ट्रीम। हर बाइट का अर्थ उसके पैकेट के भीतर स्थिति, पैकेट टाइप पहचानकर्ता और डिवाइस फ़र्मवेयर संस्करण पर निर्भर करता है। इस लेयर पर कोई मानव-पठनीय संरचना मौजूद नहीं है।
नामित फ़ंक्शन कॉल और डेटा ऑब्जेक्ट्स। enrollUser(), getAttendanceLogs(), revokeAccess()। SDK बाइनरी दुनिया को एक प्रोग्रामेटिक इंटरफ़ेस में बदलता है, जिसे डेवलपर अंतर्निहित वायर फ़ॉर्मेट के बारे में कुछ जाने बिना कॉल कर सकता है।
एक सीमित अर्थ में, SDK एक प्रोटोकॉल एडैप्टर है। यह डिवाइस के बाइनरी प्रोटोकॉल को एक कॉल किए जाने योग्य प्रोग्रामिंग इंटरफ़ेस में अनुकूलित करता है। आर्किटेक्चरल समस्या यह है कि यह अनुकूलन केवल एक दिशा में काम करता है, केवल उन्हीं मशीनों पर काम करता है जहाँ SDK इंस्टॉल है, केवल उस विशिष्ट डिवाइस ब्रांड के लिए काम करता है जिसके लिए इसे लिखा गया था, और केवल उस भाषा के execution मॉडल के भीतर काम करता है जिसके लिए SDK कंपाइल किया गया था।
SDK-आधारित आर्किटेक्चर स्केल क्यों नहीं हो सकता
SDK मॉडल उस दुनिया के लिए एक उचित समाधान था जिसके लिए यह डिज़ाइन किया गया था: एक स्थानीय मशीन पर चलने वाला एकल डेस्कटॉप एप्लिकेशन, जो लोकल एरिया नेटवर्क पर एक ही ब्रांड के डिवाइस से संवाद करता है। उस संदर्भ में SDK अच्छी तरह काम करता है। इसकी सीमाएँ तभी दिखाई देती हैं जब आर्किटेक्चरल आवश्यकताएँ बदलती हैं।
इंस्टॉलेशन निर्भरता की समस्या
SDK को उस मशीन पर इंस्टॉल होना चाहिए जो इंटीग्रेशन कोड चलाती है। इसका अर्थ है कि आपका इंटीग्रेशन कंटेनराइज़्ड क्लाउड वातावरण, serverless फ़ंक्शन, या होस्टेड ऑटोमेशन प्लेटफ़ॉर्म पर नहीं चल सकता। इसे किसी विशिष्ट मशीन पर चलना होगा जिसमें SDK फ़ाइलें मौजूद हों। यदि वह मशीन बंद कर दी जाए, दोबारा बनाई जाए, या किसी अलग ऑपरेटिंग सिस्टम पर स्थानांतरित की जाए, तो इंटीग्रेशन टूट जाता है।
वर्ष 2026 में, अधिकांश एंटरप्राइज़ सॉफ़्टवेयर इंफ़्रास्ट्रक्चर क्लाउड-नेटिव डिप्लॉयमेंट की ओर बढ़ चुका है। कंटेनर ऑर्केस्ट्रेशन, serverless फ़ंक्शन और मैनेज्ड क्लाउड सेवाएँ अब मानक हैं। SDK पर निर्भरता इस मॉडल के साथ आर्किटेक्चरल रूप से असंगत है, क्योंकि कंटेनर स्टेटलेस और अल्पकालिक होते हैं। वे डिप्लॉयमेंट के बीच इंस्टॉल की गई सॉफ़्टवेयर लाइब्रेरी को बनाए नहीं रखते।
मल्टी-ब्रांड बहुलता की समस्या
हर बायोमेट्रिक डिवाइस निर्माता अपना SDK वितरित करता है। ये SDK आपस में इंटरऑपरेबल नहीं हैं। ZKTeco SDK Hikvision डिवाइस से संवाद नहीं कर सकता। Suprema SDK Anviz डिवाइस से संवाद नहीं कर सकता। यदि आपके संगठन ने विभिन्न साइटों पर कई निर्माताओं का हार्डवेयर लगाया है, तो आपको हर ब्रांड के लिए अलग SDK इंटीग्रेशन की आवश्यकता होगी।
इससे हर रखरखाव का बोझ बढ़ जाता है। किसी एक निर्माता का फ़र्मवेयर अपडेट बाइनरी पैकेट संरचना को बदल सकता है, जिससे उस ब्रांड का SDK इंटीग्रेशन टूट सकता है जबकि बाकी अप्रभावित रहते हैं। हर इंटीग्रेशन को स्वतंत्र रूप से बनाए रखा, मॉनिटर किया और अपडेट किया जाना चाहिए।
भाषा और रनटाइम सीमा की समस्या
अधिकांश बायोमेट्रिक डिवाइस SDK, Windows-विशिष्ट बाइनरी के साथ कंपाइल्ड C या C++ लाइब्रेरी के रूप में वितरित किए जाते हैं। यदि आपकी इंटीग्रेशन लेयर Python, Node.js, या Go में लिखी गई है, तो आपको एक अतिरिक्त अनुवाद समस्या का सामना करना पड़ता है: किसी managed रनटाइम वातावरण से C लाइब्रेरी फ़ंक्शन को कॉल करने के लिए प्लेटफ़ॉर्म-विशिष्ट foreign function interface कोड की आवश्यकता होती है, जो नाज़ुक है और विभिन्न ऑपरेटिंग सिस्टम संस्करणों में बनाए रखना कठिन है।
एक इंजीनियरिंग टीम जिसने तीन बायोमेट्रिक डिवाइस ब्रांड्स के लिए SDK इंटीग्रेशन बनाए हैं, वह एक इंटीग्रेशन का रखरखाव नहीं कर रही है। वह तीन पूरी तरह अलग कोडबेस का रखरखाव कर रही है, जिनमें से हर एक का अपना कनेक्शन लॉजिक, बाइनरी पार्सिंग कोड, त्रुटि प्रबंधन और फ़र्मवेयर संगतता सतह है। जब एक फ़र्मवेयर अपडेट एक इंटीग्रेशन को तोड़ता है, तो समस्या का निदान करने के लिए उस विशिष्ट निर्माता के बाइनरी प्रोटोकॉल की गहरी जानकारी आवश्यक होती है, जो शायद ही कभी दस्तावेज़ित होती है और अक्सर केवल उस इंजीनियर के दिमाग में होती है जिसने मूल इंटीग्रेशन लिखा था।
प्रोटोकॉल एडैप्टर पैटर्न: एक औपचारिक परिभाषा
प्रोटोकॉल एडैप्टर पैटर्न एक सुस्थापित सॉफ़्टवेयर आर्किटेक्चर पैटर्न है जो दो सिस्टम्स के बीच एक समर्पित ट्रांसलेशन लेयर लाकर असंगत संचार प्रोटोकॉल की समस्या को हल करता है। एडैप्टर एक ओर स्रोत सिस्टम की मूल भाषा और दूसरी ओर लक्ष्य सिस्टम की अपेक्षित भाषा बोलता है। किसी भी सिस्टम को बदलने की आवश्यकता नहीं होती।
सॉफ़्टवेयर इंजीनियरिंग में, इस पैटर्न को कभी-कभी Adapter पैटर्न या Translator पैटर्न कहा जाता है। नेटवर्क इंजीनियरिंग में, यह प्रोटोकॉल गेटवे के पीछे का सिद्धांत है। एंटरप्राइज़ इंटीग्रेशन में, यह मैसेज ब्रोकर और इंटीग्रेशन प्लेटफ़ॉर्म का आधार है। विशिष्ट कार्यान्वयन विवरण अलग-अलग होते हैं, लेकिन मूल आर्किटेक्चरल अवधारणा समान रहती है: अनुवाद की चिंता को अलग करना, ताकि न स्रोत और न ही लक्ष्य सिस्टम को दूसरे के संचार मॉडल के बारे में जानने या चिंता करने की आवश्यकता हो।
एक यूनिवर्सल इलेक्ट्रिकल एडैप्टर आपको यूरोपीय दो-पिन प्लग वाले डिवाइस को ब्रिटिश तीन-पिन सॉकेट में लगाने देता है। न डिवाइस बदलता है, न सॉकेट। एडैप्टर दो असंगत भौतिक मानकों के बीच अनुवाद संभालता है। प्रोटोकॉल एडैप्टर सॉफ़्टवेयर संचार मानकों के लिए यही काम करता है। बायोमेट्रिक डिवाइस अपना बाइनरी प्रोटोकॉल बोलता रहता है। क्लाउड API HTTPS पर JSON बोलता रहता है। एडैप्टर इन दोनों के बीच अनुवाद करता है।
बायोमेट्रिक प्रोटोकॉल एडैप्टर की चार लेयर्स
बायोमेट्रिक डिवाइसों के लिए एक अच्छी तरह डिज़ाइन किया गया प्रोटोकॉल एडैप्टर कोई एकल फ़ंक्शन नहीं है। यह एक लेयर्ड आर्किटेक्चर है जिसमें हर लेयर की एक विशिष्ट, सीमित जिम्मेदारी होती है। इन लेयर्स को समझने से यह स्पष्ट होता है कि एक मज़बूत एडैप्टर बनाना पहली नज़र में दिखने से कहीं अधिक जटिल क्यों है, और एक उद्देश्य-निर्मित समाधान कस्टम इंटीग्रेशन की तुलना में काफ़ी अधिक विश्वसनीय क्यों है।
एडैप्टर कोर के भीतर: अनुवाद में वास्तव में क्या शामिल है
एडैप्टर कोर वह जगह है जहाँ वास्तविक जटिलता होती है। इसके पाँच घटकों में से हर एक एक विशिष्ट तकनीकी चुनौती का समाधान करता है जो सीधे इंटीग्रेशन को अव्यावहारिक बनाती है।
कनेक्शन मैनेजर
बायोमेट्रिक डिवाइस एक स्थायी TCP कनेक्शन की अपेक्षा करते हैं। कनेक्शन मैनेजर हर डिवाइस के लिए एक लंबे समय तक चलने वाला सॉकेट कनेक्शन बनाए रखता है, निर्माता-विशिष्ट हैंडशेक को संभालता है जो सॉफ़्टवेयर को डिवाइस के सामने प्रमाणित करता है, keepalive probes के माध्यम से कनेक्शन की स्थिति की निगरानी करता है, डिस्कनेक्शन का पता लगाता है, और उचित backoff समय के साथ पुनः कनेक्शन तर्क लागू करता है। कई साइटों पर फैले 50 डिवाइसों को मैनेज करने वाले सिस्टम के लिए, कनेक्शन मैनेजर एक साथ 50 समवर्ती सॉकेट सेशन चलाता है, जिनमें से हर एक की अपनी state machine होती है।
बाइनरी डिकोडर
किसी डिवाइस से आने वाला हर पैकेट निर्माता द्वारा परिभाषित एक विशिष्ट संरचना वाला बाइट्स का अनुक्रम है। बाइनरी डिकोडर इन पैकेटों को ज्ञात बाइट ऑफ़सेट पर फ़िक्स्ड-वाइड फ़ील्ड्स पढ़कर पार्स करता है, flag मान निकालने के लिए बिट मास्क लगाता है, बाइनरी-एन्कोडेड timestamps को मानक datetime फ़ॉर्मेट में बदलता है, और ऐसे character sets को डिकोड करता है जो मानक UTF-8 नहीं हो सकते। डिकोडर को कई पैकेट टाइप संभालने होते हैं, जिन्हें एक ज्ञात ऑफ़सेट पर स्थित type byte से पहचाना जाता है, और हर पैकेट टाइप को उपयुक्त पार्सिंग रूटीन तक भेजना होता है।
इवेंट नॉर्मलाइज़र
ZKTeco डिवाइस पर एक फ़िंगरप्रिंट स्कैन इवेंट अलग फ़ील्ड नामों, अलग timestamp फ़ॉर्मेट और अलग status कोड के साथ आता है, बनिस्बत उसी समतुल्य इवेंट के जो Hikvision डिवाइस पर आता है। इवेंट नॉर्मलाइज़र हर निर्माता-विशिष्ट इवेंट प्रतिनिधित्व को एक एकल, सुसंगत आंतरिक इवेंट schema में मैप करता है। यही normalization चरण Layer 3 और Layer 4 को पूरी तरह ब्रांड-अज्ञेय (brand-agnostic) बनाता है। कंज़्यूमर को इवेंट उत्पन्न करने वाले डिवाइस की परवाह किए बिना एक ही JSON संरचना प्राप्त होती है।
{
  "RealTime": {
    "OperationID": "9nu1wak5616p",
    "LabelName": "Burj Khalifa",
    "SerialNumber": "ZHM11xxxxxxxx",
    "PunchLog": {
      "Type": "CheckIn",
      "Temperature": "36.8",
      "FaceMask": false,
      "InputType": "Fingerprint",
      "UserId": "2",
      "LogTime": "2020-09-17 07:48:22 GMT +0530"
    },
    "AuthToken": "COJJ7eiiPBGUfmIQPvh2PJWWDLX7OuKs",
    "Time": "2020-09-17 04:19:03 GMT +0000"
  }
}
कमांड एन्कोडर
ऊपर दिया गया पंचलॉग पेलोड वही है जो बाइनरी डिकोडर और इवेंट नॉर्मलाइज़र तब उत्पन्न करते हैं जब किसी भौतिक डिवाइस से Biometric Gateway पर रियल-टाइम बायोमेट्रिक इवेंट आता है। इस संरचित JSON को फिर आपके कॉन्फ़िगर किए गए कॉलबैक एंडपॉइंट पर प्रकाशित किया जाता है, चाहे वह n8n Webhook node हो, AI एजेंट हो, HRMS एंडपॉइंट हो, या कोई अन्य कंज़्यूमर।
कमांड एन्कोडर विपरीत दिशा में काम करता है। जब कोई कंज़्यूमर API सरफ़ेस को JSON निर्देश भेजता है, जैसे कोई नया उपयोगकर्ता enroll करने या एक्सेस अनुमतियाँ रद्द करने का अनुरोध, तो कमांड एन्कोडर उस संरचित JSON को उस बाइनरी कमांड पैकेट में बदलता है जिसकी लक्ष्य डिवाइस अपेक्षा करता है। यह फ़ील्ड मानों को उस निर्माता के प्रोटोकॉल के लिए सही बाइट ऑफ़सेट पर रखता है, पैकेट टाइप पहचानकर्ता जोड़ता है, आवश्यक checksums की गणना करके उन्हें जोड़ता है, और परिणामी बाइनरी फ़्रेम को डिवाइस के स्थायी सॉकेट कनेक्शन पर लिखता है। वही तार्किक निर्देश, जिसे कंज़्यूमर एक बार स्वच्छ JSON के रूप में व्यक्त करता है, इस पर निर्भर करते हुए वायर पर पूरी तरह अलग बाइनरी संरचना बन जाता है कि उसे कौन सा डिवाइस ब्रांड प्राप्त कर रहा है। कमांड एन्कोडर हर भिन्नता को आंतरिक रूप से संभालता है, ताकि कंज़्यूमर को कभी इसकी चिंता न करनी पड़े।
रेज़िलिएंस हैंडलर
ऑपरेशनल वातावरण में भौतिक डिवाइस ऑफ़लाइन हो जाते हैं। पावर साइकिल, नेटवर्क बाधाएँ और डिवाइस रीस्टार्ट सामान्य घटनाएँ हैं। रेज़िलिएंस हैंडलर डिस्कनेक्शन के दौरान आने वाले इवेंट्स को बफ़र करता है ताकि वे खोएँ नहीं, ऐसे आउटगोइंग कमांड्स को कतार में रखता है जो कनेक्शन बहाल होने तक पहुँचाए नहीं जा सकते, पुनः कनेक्शन प्रयासों के लिए exponential backoff लागू करता है ताकि रीस्टार्ट होते डिवाइस पर बाढ़ न आए, और जब डिवाइस उपलब्ध न होने के कारण कोई ऑपरेशन पूरा नहीं हो पाता तो कंज़्यूमर्स को संरचित त्रुटि प्रतिक्रियाएँ भेजता है।
वे आर्किटेक्चरल गुण जो एक अच्छे प्रोटोकॉल एडैप्टर को परिभाषित करते हैं
सभी प्रोटोकॉल एडैप्टर एक जैसे नहीं होते। एक अच्छी तरह डिज़ाइन किए गए एडैप्टर में कुछ विशिष्ट आर्किटेक्चरल गुण होते हैं जो इसे एक नाज़ुक कस्टम इंटीग्रेशन से अलग करते हैं।
क्लाउड डिप्लॉयमेंट एडैप्टर आर्किटेक्चर की आवश्यकताएँ कैसे बदलता है
ऑन-प्रिमाइसेस से क्लाउड-नेटिव एंटरप्राइज़ इंफ़्रास्ट्रक्चर की ओर बदलाव यह मूल रूप से बदल देता है कि प्रोटोकॉल एडैप्टर को कैसा होना चाहिए। ऑन-प्रिमाइसेस डिप्लॉयमेंट के लिए डिज़ाइन किया गया एडैप्टर लोकल SDK इंस्टॉलेशन, फ़िक्स्ड नेटवर्क कॉन्फ़िगरेशन और स्थायी सर्वर प्रोसेस पर निर्भर रह सकता है। क्लाउड डिप्लॉयमेंट के लिए डिज़ाइन किया गया एडैप्टर इनमें से किसी पर भी निर्भर नहीं रह सकता।
स्टेटलेस बनाम स्टेटफ़ुल डिज़ाइन
क्लाउड-नेटिव डिप्लॉयमेंट वातावरण स्टेटलेस प्रोसेस को प्राथमिकता देते हैं। एक स्टेटलेस प्रोसेस को महत्वपूर्ण डेटा खोए बिना शुरू, बंद और रीस्टार्ट किया जा सकता है, क्योंकि सारी स्थायी स्थिति बाहर संग्रहीत होती है। बायोमेट्रिक डिवाइस कनेक्शन स्वभाव से स्टेटफ़ुल होते हैं: उन्हें एक स्थायी सॉकेट चाहिए जो इंटरैक्शन के बीच कनेक्शन संदर्भ को बनाए रखे। एक क्लाउड-नेटिव प्रोटोकॉल एडैप्टर को इस स्थिति को बाहर externalize करना होगा, कनेक्शन मेटाडेटा को एक स्थायी स्टोर में रखना होगा ताकि प्रोसेस रीस्टार्ट होने पर भी कनेक्शन संदर्भ बना रहे।
API सर्विंग से कनेक्शन मैनेजमेंट का अलगाव
एक अच्छी तरह से आर्किटेक्टेड क्लाउड प्रोटोकॉल एडैप्टर कनेक्शन मैनेजमेंट लेयर को API सर्विंग लेयर से अलग रखता है। कनेक्शन मैनेजमेंट लेयर एक समर्पित सेवा के रूप में चलती है जो स्थायी डिवाइस कनेक्शन बनाए रखती है और सामान्यीकृत इवेंट्स को एक आंतरिक message queue पर प्रकाशित करती है। API सर्विंग लेयर उस queue से पढ़ती है और REST अनुरोधों को स्वतंत्र रूप से सेवा देती है। यह अलगाव हर लेयर को स्वतंत्र रूप से scale करने देता है, और इसका अर्थ है कि API सर्विंग प्रोसेस के रीस्टार्ट होने से सक्रिय डिवाइस कनेक्शन बाधित नहीं होते।
यदि आपका API सर्वर और आपका डिवाइस कनेक्शन मैनेजर एक ही प्रोसेस हैं, तो अपडेट डिप्लॉय करने के लिए API सर्वर को रीस्टार्ट करने से सभी सक्रिय डिवाइस कनेक्शन टूट जाते हैं। यदि वे अलग प्रोसेस हैं, तो आप कनेक्शन मैनेजर को छुए बिना API सर्वर पर अपडेट डिप्लॉय कर सकते हैं, और सक्रिय डिवाइस कनेक्शन बिना बाधा के बने रहते हैं। ऐसे ऑपरेशनल वातावरण में जहाँ डिवाइस लगातार attendance इवेंट्स प्रोसेस कर रहे हों, कनेक्शन की निरंतरता कोई सुविधा नहीं है। यह डेटा अखंडता की आवश्यकता है।
माइग्रेशन पथ: SDK से प्रोटोकॉल एडैप्टर तक जाना
जो संगठन वर्तमान में SDK-आधारित इंटीग्रेशन पर निर्भर हैं, उन्हें सब कुछ एक साथ दोबारा बनाने की आवश्यकता नहीं है। प्रोटोकॉल एडैप्टर आर्किटेक्चर को धीरे-धीरे लागू करने के लिए डिज़ाइन किया गया है, जिसमें एडैप्टर मौजूदा SDK इंटीग्रेशन से जिम्मेदारियाँ क्रमिक रूप से अपने हाथ में लेता है।
प्रोटोकॉल एडैप्टर डिज़ाइन में अनुपालन संबंधी विचार
जब बायोमेट्रिक डेटा किसी प्रोटोकॉल एडैप्टर से होकर बहता है, तो अधिकांश डेटा संरक्षण ढाँचों के अंतर्गत कानूनी अर्थ में एडैप्टर एक डेटा प्रोसेसर बन जाता है। इससे विशिष्ट डिज़ाइन दायित्व उत्पन्न होते हैं जिन्हें एडैप्टर आर्किटेक्चर में संबोधित किया जाना चाहिए।
- GDPR, EU: एडैप्टर को normalization लेयर पर डेटा न्यूनीकरण (data minimization) लागू करना चाहिए। कंज़्यूमर्स को पास किए गए इवेंट डेटा में केवल वही फ़ील्ड होने चाहिए जो विशिष्ट उद्देश्य के लिए आवश्यक हों। एडैप्टर बायोमेट्रिक टेम्पलेट डेटा को चल रहे ऑपरेशन के लिए आवश्यक समय से अधिक समय तक नहीं रखना चाहिए।
- CCPA और CPRA, कैलिफ़ोर्निया: एडैप्टर बायोमेट्रिक डेटा को ऐसे तरीकों से कंज़्यूमर्स के लिए उपलब्ध नहीं कराना चाहिए जो सहमति वाले उद्देश्य से आगे प्रोफ़ाइलिंग या पुनः पहचान (re-identification) को सक्षम करें। API एक्सेस नियंत्रण को कंज़्यूमर स्तर पर उद्देश्य सीमितता (purpose limitation) लागू करनी चाहिए।
- LGPD, ब्राज़ील: प्रोसेसिंग रिकॉर्ड्स में एडैप्टर को एक प्रोसेसिंग घटक के रूप में दस्तावेज़ित करना होगा, उसकी विशिष्ट भूमिका, वह डेटा जिसे वह छूता है, और हर लेयर पर लागू retention नियम।
- PDPA, सिंगापुर, मलेशिया, थाईलैंड: API सरफ़ेस पर एक्सेस नियंत्रणों को सहमति-आधारित प्रतिबंध लागू करने चाहिए। कंज़्यूमर्स को केवल उन्हीं उद्देश्यों के लिए डेटा प्राप्त होना चाहिए जिनके लिए डेटा विषय ने सहमति दी है।
- ISO 27001-संरेखित नियंत्रण: एडैप्टर को डिवाइस कनेक्शन लेयर (जहाँ डिवाइस प्रोटोकॉल अनुमति दे) और API सरफ़ेस लेयर, दोनों पर ट्रांज़िट में एन्क्रिप्शन लागू करना चाहिए। API एंडपॉइंट्स तक पहुँच प्रमाणित होनी चाहिए। सभी ऑपरेशन्स से अपरिवर्तनीय (immutable) ऑडिट लॉग प्रविष्टियाँ बननी चाहिए।
अक्सर पूछे जाने वाले प्रश्न
निष्कर्ष: Cams Biometrics Gateway वही आर्किटेक्चर है, जो बनाया और चलाया जा रहा है
प्रोटोकॉल एडैप्टर आर्किटेक्चर बायोमेट्रिक इंटीग्रेशन समस्या का सही इंजीनियरिंग उत्तर है। यह कोई अस्थायी उपाय नहीं है। यह एक सुस्थापित पैटर्न है, जिसे एक विशिष्ट क्षेत्र में लागू किया गया है जहाँ इसकी तत्काल आवश्यकता है।
Cams Biometrics Gateway इस आर्किटेक्चर का एक प्रोडक्शन कार्यान्वयन है। यह 15 या अधिक निर्माताओं के डिवाइसों के साथ स्थायी कनेक्शन बनाए रखता है, हर समर्थित प्रोटोकॉल के लिए एक बाइनरी डिकोडर और इवेंट नॉर्मलाइज़र चलाता है, और पूरा ऑपरेशन सेट एक एकीकृत REST API और MCP server के माध्यम से उपलब्ध कराता है। परिणाम यह है कि मानक HTTPS पर JSON के माध्यम से 38 बायोमेट्रिक ऑपरेशन उपलब्ध हैं, हर डिवाइस इवेंट के लिए रियल-टाइम webhook callbacks हैं, और आपके इंफ़्रास्ट्रक्चर में कहीं भी SDK इंस्टॉलेशन की आवश्यकता नहीं है।
यदि आपके संगठन के पास बायोमेट्रिक डिवाइस हैं और ऐसे सिस्टम हैं जिन्हें बायोमेट्रिक डेटा का उपभोग करना है, तो प्रोटोकॉल एडैप्टर लेयर वह आर्किटेक्चरल हिस्सा है जिसकी आपके पास कमी है। CamsBiometrics.com पर Cams Biometrics Gateway API का अन्वेषण करें, या अपने मौजूदा हार्डवेयर को उस आधुनिक क्लाउड API लेयर से जोड़ने के बारे में हमारी टीम से बात करें, जिसकी वह हकदार है।