 Cams Support Hub
Architecture à adaptateurs de protocole : du SDK hérité à l'API cloud
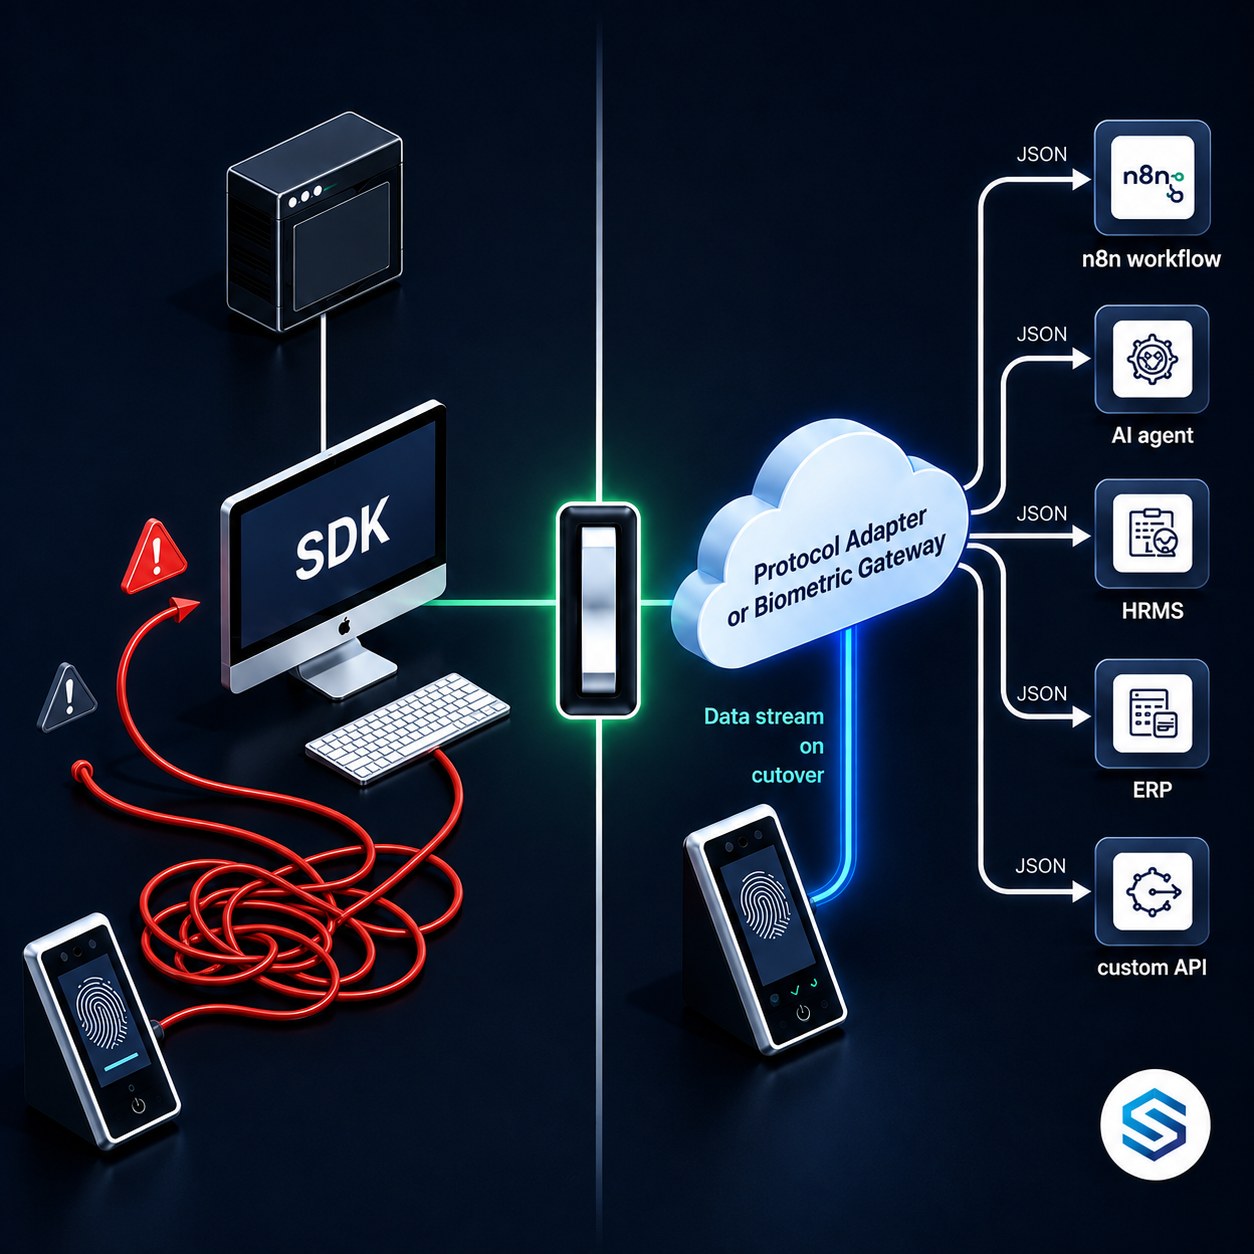
La plupart des systèmes d'entreprise n'ont pas été conçus pour communiquer entre eux. Ils ont été conçus pour accomplir une tâche précise, en utilisant le modèle de communication qui avait du sens au moment de leur conception. L'architecture à adaptateurs de protocole est la discipline d'ingénierie qui relie ces mondes sans réécrire l'un ni l'autre. Cet article explique ce que sont les adaptateurs de protocole, comment ils fonctionnent d'un point de vue technique, et pourquoi ils constituent la solution la plus pragmatique à l'un des problèmes les plus persistants de l'intégration en entreprise : le terminal biométrique.
Ce qu'est un protocole et pourquoi il crée un verrouillage
Avant de comprendre les adaptateurs de protocole, il faut une définition claire de ce qu'est réellement un protocole. Dans la communication logicielle et matérielle, un protocole est un ensemble de règles qui régissent la manière dont les données sont formatées, transmises et interprétées entre deux parties. Il définit la structure des paquets, le modèle de connexion, la séquence de prise de contact, le format d'encodage et le comportement de gestion des erreurs.
Les protocoles créent un verrouillage parce qu'ils exigent que les deux parties parlent la même langue. Si vous écrivez un logiciel qui communique à l'aide du Protocole A, il ne peut communiquer qu'avec les systèmes qui implémentent également le Protocole A. Tout système utilisant le Protocole B, même s'il est fonctionnellement similaire, est inaccessible sans une couche de traduction.
Ce n'est pas un défaut de conception des protocoles. C'est une conséquence inévitable de la communication structurée. Le problème survient lorsque le protocole utilisé par un appareil ou un système devient obsolète par rapport aux normes de communication vers lesquelles le reste de l'écosystème a évolué. L'appareil fonctionne toujours. Ses données ont toujours de la valeur. Mais son protocole est devenu un mur.
Un terminal biométrique à empreintes digitales fabriqué en 2010 communique à l'aide d'un protocole TCP binaire défini par son fabricant. Le terminal enregistre fidèlement les données de présence chaque jour. Mais le SIRH que votre entreprise a adopté en 2023 communique via REST et JSON sur HTTPS. Ces deux systèmes ne partagent aucun protocole commun. Ils ne peuvent pas communiquer directement, quelles que soient les capacités de chacun pris individuellement. Les données du terminal sont inaccessibles pour le SIRH, sauf si quelque chose assure la traduction entre les deux protocoles.
Le SDK comme décodeur de protocole : ce qu'il fait réellement
Lorsqu'un fabricant de terminaux biométriques ne peut pas exposer son appareil via un protocole standard, il distribue un SDK. Comprendre ce que fait réellement un SDK au niveau technique permet d'expliquer à la fois pourquoi il existe et pourquoi il pose de si importants problèmes d'architecture.
Un SDK, ou Software Development Kit, est un ensemble de bibliothèques de code compilé, de fichiers d'en-tête et de documentation qu'un développeur installe sur une machine pour permettre la communication avec un appareil ou un service spécifique. Dans le contexte des terminaux biométriques, le SDK remplit deux fonctions essentielles.
D'abord, il gère la couche de connexion. Le SDK établit et maintient la connexion TCP persistante que l'appareil attend. Il gère la séquence de prise de contact, maintient la connexion active et gère la reconnexion lorsque l'appareil passe hors ligne. Ce code de gestion de connexion est complexe et entièrement propre à l'implémentation du protocole du fabricant.
Ensuite, il gère la couche de décodage. Chaque paquet envoyé par l'appareil arrive sous forme d'octets binaires bruts. Le SDK contient des tables de correspondance, des masques binaires et des fonctions d'analyse qui décodent ces octets en structures de données significatives avec lesquelles un développeur peut travailler. Sans cette couche de décodage, le flux binaire provenant de l'appareil n'a aucun sens.
Un flux continu d'octets binaires sur une socket TCP persistante. La signification de chaque octet dépend de sa position dans le paquet, de l'identifiant du type de paquet et de la version du micrologiciel de l'appareil. Aucune structure lisible par l'humain n'existe à ce niveau.
Des appels de fonctions nommés et des objets de données. enrollUser(), getAttendanceLogs(), revokeAccess(). Le SDK traduit le monde binaire en une interface de programmation qu'un développeur peut appeler sans rien connaître du format de transmission sous-jacent.
Le SDK est, dans une mesure limitée, un adaptateur de protocole. Il adapte le protocole binaire de l'appareil en une interface de programmation appelable. Le problème architectural est que cette adaptation ne fonctionne que dans un seul sens, uniquement sur les machines où le SDK est installé, uniquement pour la marque d'appareil pour laquelle il a été écrit, et uniquement dans le modèle d'exécution du langage pour lequel le SDK a été compilé.
Pourquoi une architecture basée sur des SDK ne peut pas passer à l'échelle
Le modèle SDK était une solution raisonnable pour le monde pour lequel il a été conçu : une application de bureau unique, fonctionnant sur une machine locale, communiquant avec une seule marque d'appareil sur un réseau local. Dans ce contexte, le SDK fonctionne bien. Les limites ne deviennent visibles que lorsque les exigences architecturales changent.
Le problème de la dépendance à l'installation
Un SDK doit être installé sur la machine qui exécute le code d'intégration. Cela signifie que votre intégration ne peut pas fonctionner dans un environnement cloud conteneurisé, une fonction serverless ou une plateforme d'automatisation hébergée. Elle doit s'exécuter sur une machine spécifique où les fichiers du SDK sont présents. Si cette machine est mise hors service, reconstruite ou migrée vers un autre système d'exploitation, l'intégration cesse de fonctionner.
En 2026, la plupart des infrastructures logicielles d'entreprise ont évolué vers un déploiement cloud natif. L'orchestration de conteneurs, les fonctions serverless et les services cloud gérés sont devenus la norme. Une dépendance à un SDK est architecturalement incompatible avec ce modèle, car les conteneurs sont sans état et éphémères. Ils ne conservent pas les bibliothèques logicielles installées entre les déploiements.
Le problème de la multiplicité des marques
Chaque fabricant de terminaux biométriques distribue son propre SDK. Ces SDK ne sont pas interopérables. Le SDK ZKTeco ne peut pas communiquer avec un appareil Hikvision. Le SDK Suprema ne peut pas communiquer avec un appareil Anviz. Si votre organisation a déployé du matériel de plusieurs fabricants sur différents sites, vous avez besoin d'une intégration SDK distincte pour chaque marque.
Cela multiplie chaque charge de maintenance. Une mise à jour du micrologiciel d'un fabricant peut modifier la structure binaire des paquets, cassant l'intégration SDK de cette marque tout en laissant les autres intactes. Chaque intégration doit être maintenue, surveillée et mise à jour de manière indépendante.
Le problème de la frontière entre langages et environnements d'exécution
La plupart des SDK de terminaux biométriques sont distribués sous forme de bibliothèques C ou C++ compilées avec des binaires spécifiques à Windows. Si votre couche d'intégration est écrite en Python, Node.js ou Go, vous faites face à un problème de traduction supplémentaire : appeler des fonctions de bibliothèques C depuis un environnement d'exécution géré nécessite du code d'interface de fonctions étrangères propre à chaque plateforme, fragile et difficile à maintenir d'une version de système d'exploitation à l'autre.
Une équipe d'ingénierie qui a développé des intégrations SDK pour trois marques de terminaux biométriques ne maintient pas une seule intégration. Elle maintient trois bases de code entièrement distinctes, chacune avec sa propre logique de connexion, son propre code d'analyse binaire, sa propre gestion des erreurs et sa propre compatibilité avec les micrologiciels. Lorsqu'une mise à jour du micrologiciel casse une intégration, le diagnostic exige une connaissance approfondie du protocole binaire de ce fabricant précis, connaissance rarement documentée et souvent présente uniquement dans la tête de l'ingénieur qui a écrit l'intégration à l'origine.
Le modèle d'adaptateur de protocole : une définition formelle
Le modèle d'adaptateur de protocole est une architecture logicielle bien établie qui résout le problème des protocoles de communication incompatibles en introduisant une couche de traduction dédiée entre les deux systèmes. L'adaptateur parle la langue native du système source d'un côté et la langue attendue du système cible de l'autre. Aucun des deux systèmes n'a besoin de changer.
En génie logiciel, ce modèle est parfois appelé modèle Adapter ou modèle Translator. En ingénierie réseau, il est le principe qui sous-tend les passerelles de protocoles. Dans l'intégration d'entreprise, il est à la base des courtiers de messages et des plateformes d'intégration. Les détails de mise en œuvre varient, mais le concept architectural central reste constant : isoler la préoccupation de traduction afin que ni le système source ni le système cible n'aient à connaître ou à se soucier du modèle de communication de l'autre.
Un adaptateur électrique universel vous permet de brancher un appareil doté d'une fiche européenne à deux broches dans une prise britannique à trois broches. L'appareil ne change pas. La prise ne change pas. L'adaptateur assure la traduction entre deux normes physiques incompatibles. Un adaptateur de protocole fait de même pour les normes de communication logicielle. Le terminal biométrique continue de parler son protocole binaire. L'API cloud continue de parler JSON sur HTTPS. L'adaptateur assure la traduction entre les deux.
Les quatre couches d'un adaptateur de protocole biométrique
Un adaptateur de protocole biométrique bien conçu n'est pas une fonction unique. C'est une architecture en couches où chaque couche a une responsabilité précise et délimitée. Comprendre ces couches permet d'expliquer pourquoi la construction d'un adaptateur robuste est plus complexe qu'il n'y paraît au premier abord, et pourquoi une solution dédiée est nettement plus fiable qu'une intégration sur mesure.
À l'intérieur du cœur de l'adaptateur : ce que la traduction implique réellement
C'est dans le cœur de l'adaptateur que réside la véritable complexité. Chacun de ses cinq composants répond à un défi technique précis qui rend l'intégration directe impraticable.
Gestionnaire de connexions
Les terminaux biométriques attendent une connexion TCP persistante. Le gestionnaire de connexions maintient une socket longue durée par appareil, gère la séquence de prise de contact propre au fabricant qui authentifie le logiciel auprès de l'appareil, surveille l'état de la connexion au moyen de sondes keepalive, détecte les déconnexions et exécute la logique de reconnexion avec une temporisation de recul appropriée. Pour un système gérant 50 appareils répartis sur plusieurs sites, le gestionnaire de connexions fait fonctionner simultanément 50 sessions de socket concurrentes, chacune avec sa propre machine à états.
Décodeur binaire
Chaque paquet reçu d'un appareil est une séquence d'octets dont la structure est définie par le fabricant. Le décodeur binaire analyse ces paquets en lisant des champs de largeur fixe à des décalages d'octets connus, en appliquant des masques binaires pour extraire les valeurs des indicateurs, en convertissant les horodatages encodés en binaire vers des formats de date et heure standard, et en décodant des jeux de caractères qui ne sont pas nécessairement de l'UTF-8 standard. Le décodeur doit gérer plusieurs types de paquets, identifiés par un octet de type à un décalage connu, et acheminer chaque type de paquet vers la routine d'analyse appropriée.
Normaliseur d'événements
Un événement de scan d'empreinte digitale sur un appareil ZKTeco arrive avec des noms de champs, des formats d'horodatage et des codes de statut différents de ceux de l'événement équivalent sur un appareil Hikvision. Le normaliseur d'événements fait correspondre chaque représentation d'événement propre au fabricant à un schéma d'événement interne unique et cohérent. Cette étape de normalisation permet à la couche 3 et à la couche 4 d'être entièrement indépendantes de la marque. Le consommateur reçoit la même structure JSON quel que soit l'appareil ayant généré l'événement.
{
  "RealTime": {
    "OperationID": "9nu1wak5616p",
    "LabelName": "Burj Khalifa",
    "SerialNumber": "ZHM11xxxxxxxx",
    "PunchLog": {
      "Type": "CheckIn",
      "Temperature": "36.8",
      "FaceMask": false,
      "InputType": "Fingerprint",
      "UserId": "2",
      "LogTime": "2020-09-17 07:48:22 GMT +0530"
    },
    "AuthToken": "COJJ7eiiPBGUfmIQPvh2PJWWDLX7OuKs",
    "Time": "2020-09-17 04:19:03 GMT +0000"
  }
}
Encodeur de commandes
La charge utile de pointage ci-dessus est ce que le décodeur binaire et le normaliseur d'événements produisent lorsqu'un événement biométrique en temps réel arrive à la passerelle biométrique depuis un appareil physique. Ce JSON structuré est ensuite publié vers le point de terminaison de rappel configuré, qu'il s'agisse d'un nœud Webhook n8n, d'un agent IA, d'un point de terminaison SIRH ou de tout autre consommateur.
L'encodeur de commandes fonctionne dans le sens inverse. Lorsqu'un consommateur envoie une instruction JSON à la surface API, par exemple une demande d'enrôlement d'un nouvel utilisateur ou de révocation des droits d'accès, l'encodeur de commandes traduit ce JSON structuré en paquet de commande binaire attendu par l'appareil cible. Il place les valeurs des champs aux décalages d'octets corrects pour le protocole de ce fabricant, ajoute l'identifiant du type de paquet, calcule et ajoute les sommes de contrôle requises, puis écrit la trame binaire résultante sur la socket persistante de l'appareil. La même instruction logique, exprimée une seule fois en JSON propre par le consommateur, devient une structure binaire totalement différente sur le fil selon la marque de l'appareil qui la reçoit. L'encodeur de commandes gère toutes ces variations en interne afin que le consommateur n'ait jamais à le faire.
Gestionnaire de résilience
Les appareils physiques dans les environnements opérationnels passent hors ligne. Les coupures de courant, les interruptions réseau et les redémarrages d'appareils sont des événements courants. Le gestionnaire de résilience met en tampon les événements reçus pendant une déconnexion afin qu'ils ne soient pas perdus, met en file d'attente les commandes sortantes qui ne peuvent être livrées tant que la connexion n'est pas rétablie, applique une temporisation exponentielle entre les tentatives de reconnexion pour éviter de surcharger un appareil en cours de redémarrage, et renvoie aux consommateurs des réponses d'erreur structurées lorsqu'une opération ne peut être menée à bien en raison de l'indisponibilité de l'appareil.
Les propriétés architecturales qui définissent un bon adaptateur de protocole
Tous les adaptateurs de protocole ne se valent pas. Un adaptateur bien conçu possède des propriétés architecturales précises qui le distinguent d'une intégration sur mesure fragile.
Pourquoi le déploiement cloud modifie les exigences de l'architecture d'adaptateur
Le passage d'une infrastructure d'entreprise sur site à une infrastructure cloud native change fondamentalement ce que doit être un adaptateur de protocole. Un adaptateur conçu pour un déploiement sur site peut s'appuyer sur des installations SDK locales, des configurations réseau fixes et des processus serveur persistants. Un adaptateur conçu pour un déploiement cloud ne peut s'appuyer sur aucun de ces éléments.
Conception sans état ou avec état
Les environnements de déploiement cloud natifs privilégient les processus sans état. Un processus sans état peut être démarré, arrêté et redémarré sans perte de données importantes, car tout l'état persistant est stocké à l'extérieur. Les connexions aux terminaux biométriques sont intrinsèquement avec état : elles nécessitent une socket persistante qui conserve le contexte de connexion entre les échanges. Un adaptateur de protocole cloud natif doit externaliser cet état, en conservant les métadonnées de connexion dans un magasin persistant afin que le contexte de connexion survive aux redémarrages des processus.
La séparation entre la gestion des connexions et le service de l'API
Un adaptateur de protocole cloud bien architecturé sépare la couche de gestion des connexions de la couche de service de l'API. La couche de gestion des connexions fonctionne comme un service dédié qui maintient les connexions persistantes aux appareils et publie les événements normalisés vers une file de messages interne. La couche de service de l'API lit cette file et répond indépendamment aux requêtes REST. Cette séparation permet à chaque couche de passer à l'échelle de manière indépendante et signifie qu'un redémarrage du processus de service de l'API n'interrompt pas les connexions actives aux appareils.
Si votre serveur API et votre gestionnaire de connexions aux appareils sont le même processus, redémarrer le serveur API pour déployer une mise à jour interrompt toutes les connexions actives aux appareils. S'ils sont séparés, vous pouvez déployer des mises à jour du serveur API sans toucher au gestionnaire de connexions, et les connexions actives aux appareils restent ininterrompues. Dans un environnement opérationnel où les appareils traitent en continu des événements de présence, la continuité des connexions n'est pas un confort. C'est une exigence d'intégrité des données.
La voie de migration : passer du SDK à l'adaptateur de protocole
Les organisations qui s'appuient actuellement sur des intégrations basées sur des SDK n'ont pas besoin de tout reconstruire d'un seul coup. L'architecture à adaptateurs de protocole est conçue pour être introduite progressivement, l'adaptateur reprenant peu à peu les responsabilités de l'intégration SDK existante.
Considérations de conformité dans la conception d'un adaptateur de protocole
Lorsque des données biométriques transitent par un adaptateur de protocole, l'adaptateur devient, au sens juridique, un sous-traitant de données dans la plupart des cadres de protection des données. Cela crée des obligations de conception spécifiques qui doivent être prises en compte dans l'architecture de l'adaptateur.
- RGPD, UE : L'adaptateur doit appliquer la minimisation des données au niveau de la couche de normalisation. Les données d'événements transmises aux consommateurs ne doivent contenir que les champs nécessaires à la finalité précise. L'adaptateur ne doit pas conserver les données de gabarit biométrique plus longtemps que nécessaire pour l'opération en cours.
- CCPA et CPRA, Californie : L'adaptateur ne doit pas rendre les données biométriques accessibles aux consommateurs d'une manière qui permette le profilage ou la réidentification au-delà de la finalité consentie. Les contrôles d'accès à l'API doivent faire respecter la limitation de finalité au niveau de chaque consommateur.
- LGPD, Brésil : Les registres de traitement doivent documenter l'adaptateur comme un composant de traitement, avec son rôle spécifique, les données qu'il manipule et les règles de conservation appliquées à chaque couche.
- PDPA, Singapour, Malaisie, Thaïlande : Les contrôles d'accès sur la surface API doivent faire respecter des restrictions fondées sur le consentement. Les consommateurs ne doivent recevoir que les données pour les finalités auxquelles la personne concernée a consenti.
- Contrôles alignés sur ISO 27001 : L'adaptateur doit appliquer le chiffrement en transit à la fois au niveau de la connexion aux appareils (lorsque le protocole de l'appareil le permet) et au niveau de la surface API. L'accès aux points de terminaison API doit être authentifié. Toutes les opérations doivent générer des entrées de journal d'audit immuables.
Questions fréquentes
Conclusion : la Passerelle biométrique Cams Biometrics est cette architecture, construite et en service
L'architecture à adaptateurs de protocole est la bonne réponse d'ingénierie au problème de l'intégration biométrique. Ce n'est pas un contournement. C'est un modèle bien établi appliqué à un domaine précis où il est urgemment nécessaire.
Cams Biometrics Gateway est une implémentation en production de cette architecture. Elle maintient des connexions persistantes avec des appareils de 15 fabricants ou plus, exécute un décodeur binaire et un normaliseur d'événements pour chaque protocole pris en charge, et expose l'ensemble des opérations via une API REST unifiée et un serveur MCP. Le résultat est 38 opérations biométriques accessibles via JSON standard sur HTTPS, avec des rappels webhook en temps réel pour chaque événement d'appareil, et aucune installation de SDK nécessaire nulle part dans votre infrastructure.
Si votre organisation dispose de terminaux biométriques et de systèmes qui doivent exploiter des données biométriques, la couche d'adaptateur de protocole est l'élément architectural qui vous manque. Découvrez l'API de Cams Biometrics Gateway sur CamsBiometrics.com ou contactez notre équipe pour connecter votre matériel existant à la couche d'API cloud moderne qu'il mérite.